2025年のAI論文5選
2025年に注目を集めた5本の研究を取り上げ、推論を引き出す強化学習、エージェント評価、長期タスク指標、幻覚の統計的説明などの要点と限界を整理します。
目次
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
- Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?
- τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- Measuring AI Ability to Complete Long Tasks
- Why Language Models Hallucinate
- おわりに
- 脚注
2025年は、LLMの推論を引き出す事後学習が大きく前進し、同時に信頼性や責任ある利用を支える評価基盤も整い始めた年でした。産業界ではGPT-5、Gemini 3、Claude 4.5のような強力なモデルに加え、CursorやClaude Codeといったエージェント型アプリケーションが広がり、開発や学習の体験が急速に変わりました。こうした変化を追うためには製品に触れることが近道ですが、現在の課題や数年先に何が起こり得るかを見通すには、学術界の動向を押さえておくのも有効です。そこで本記事では、AI技術にキャッチアップし続けたいエンジニアやテック業界の方々に向けて、個人的に重要だと感じた2025年の研究を5本取り上げ、その意義と限界、今後の展望を整理します。
ご興味があれば、2024年の振り返りもご覧ください。
DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
- Authors: DeepSeek AI
- Paper: https://arxiv.org/abs/2501.12948v1
- Model weight: https://huggingface.co/deepseek-ai/DeepSeek-R1
- Venue: Nature
Incentivizing Reasoning Capability in LLMs via RL [DeepSeek-AI, 2025]
— Shion Honda (@shion_honda) February 2, 2025
正答に報酬を与えるGRPOをベースモデルに直接適用することでo1並みの推論能力を引き出すことに成功(R1-Zero)。SFTモデルから始めたR1や蒸留モデルも開発し、重みを公開した。https://t.co/5n5aX6wcId#NowReading pic.twitter.com/tY7TIynJoG
DeepSeek AIが発表した本論文は、人手の推論データに頼らずに、強化学習によってLLMから多段推論を引き出すことを狙った試みです。著者らはDeepSeek V3(ベースモデル)に対し、group relative policy optimization (GRPO) 1 を用いた強化学習を行い、数学やプログラミング問題の正解判定だけを報酬信号にしました。学習時は <think/> と <answer/> タグを用いたテンプレートで、よく考えてから回答することだけをモデルに要求します。するとモデルは自発的に検証や自己反省、戦略の切り替えといった長い思考の連鎖(chain-of-thought; CoT)を生み出し、AIME 2024のpass@1が15.6%から71.0%へ向上するなど、大きな改善が報告されました。
本論文の特に面白い点は以下の2つです:
- 人手に頼らない事後学習:LLMの事後学習ではsupervised fine-tuning(SFT)とreinforcement learning from human feedback (RLHF)の2ステップが必要とされていました。R1-zeroは、人手アノテーションに依存しバイアスを含みやすいこれらの手法に対して、数学などの検証可能な問題の正解だけを報酬とするアプローチを取りました。そして、Tulu 32で議論されたreinforcement learning with verifiable rewards(RLVR)が、実際にOpenAI o1レベルの性能を引き出せるということを実証しました。ただし、SFTやRLHFが無意味になったというわけではなく、R1-zeroには言語の混同などの問題があったため、著者らは追加のSFTを施したR1も開発しました。
- 長考の創発:強化学習の途中で推論時間が徐々に伸び、正解にたどり着くまで自己修正を繰り返す挙動が観察されました。難しい問題では1万トークンもの長い推論をすることもあったそうです。R1が出るまで、業界ではo1を再現するための試行錯誤が活発になされていましたが、本論文によって長考を創発させるレシピが公開されたというのは非常に大きなインパクトでした。論文中ではプロセス報酬モデルやMonte-Carlo木探索などうまくいかなかったアプローチについても議論されています。
DeepSeek AIはR1系列のモデルをV3系列とともにオープンウェイトで公開しました。2025年1月にこのモデルが公開されると、各国のAppStoreでDeepSeekアプリが一時的にChatGPTを抜いて1位となり、NVIDIAの株価が下落するほどの騒ぎ(いわゆるDeepSeekショック)に発展しました。AlibabaやMoonshot AI、Z.aiなどの中国企業はこの波に乗り、クローズドモデルに匹敵する性能を持つオープンモデルを続々と公開しています。
本論文にご興味があれば、2025年3月に私が書いたブログ記事もご参照ください。
Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?
- Authors: Yang Yue, Zhiqi Chen, Rui Lu, Andrew Zhao, Zhaokai Wang, Yang Yue, Shiji Song, Gao Huang
- Paper: https://openreview.net/forum?id=4OsgYD7em5
- Project page: https://limit-of-rlvr.github.io/
- Code: https://github.com/LeapLabTHU/limit-of-RLVR
- Venue: NeurIPS 2025
Does RL incentivize reasoning capacity in LLMs? [Yue+, 2025, NeurIPS]
— Shion Honda (@shion_honda) December 14, 2025
RLVRはサンプル効率を高めるがベースモデルにない推論パターンを生み出せはしないということを、大きなkでのpass@kを調べることで実証。一方、蒸留は分布自体を教師に寄せて拡張できる。https://t.co/H7erJQRnPX#NowReading pic.twitter.com/eDIzc7oW7W
本論文は、前の論文で触れたRLVRの限界を調べた重要な研究です。著者らはDeepSeek R1など複数のRLVR訓練済みモデルを対象に、数学、コーディング、視覚推論などのベンチマークでpass@kを大きなkまで測定しました。その結果、小さなkではRLVRモデルがベースモデルを上回る一方、kを増やすとベースモデルが追い抜き、最終的にRLVRモデルを上回ることがわかりました。さらに探索空間を分析すると、RLVRモデルの生成分布はベースモデルに含まれる解答に偏っており、RLVRは新しい推論能力を生み出すのではなく、既存の解答のサンプリング効率を改善しているにとどまることが示されました。
なぜこのような現象が起きるのでしょうか。根底には、0/1報酬による探索の難しさがあります。RLVRでは正しい出力にのみ報酬が与えられるため、ベースモデルが解けない問題では勾配が得られません。その結果、モデルは既知の当たりやすいパターンに集中し、報酬のある解答周辺に分布が鋭く集中していきます。するとベースモデルが持っていた多様な推論パターンが失われ、pass@kのkを大きくしたときにベースモデル側の多様性が効いて逆転が起きます。一方で蒸留(distillation)は、教師が持つ推論パターンを生徒モデルに注入できます。
新しい能力を獲得するためのアプローチとして、著者らは、途中経過に報酬を与えるプロセス報酬や価値関数によるクレジット割り当て、大規模・動的なデータによるカリキュラム学習、より強力な探索手法、ツール利用を含むエージェントフレームワークなどが有望だと指摘しています。価値関数によるクレジット割り当ては、Ilya Sutskeverも最近のインタビューで将来性があると語っていました。
τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- Authors: Shunyu Yao, Noah Shinn, Pedram Razavi, Karthik Narasimhan
- Paper: https://openreview.net/forum?id=roNSXZpUDN
- Project page: https://taubench.com/
- Code: https://github.com/sierra-research/tau2-bench
- Venue: ICLR 2025
A Benchmark for Tool-Agent-User Interaction in Real-World Domains [Yao+, 2024]
— Shion Honda (@shion_honda) March 23, 2025
エージェントの単なるタスク遂行ではなく、人間との対話やドメイン独自(小売と航空)のルールの遵守の能力を評価するτ-benchを提案。pass^kで出力の一貫性を評価する。https://t.co/Cmuch8sg6v#NowReading pic.twitter.com/o1yUqyVuij
Sierra AIの研究者らは、従来のエージェントベンチマークが単発の対話やAPI呼び出しのみを評価しており、現実のユーザーとの複数ターン対話やドメイン固有の規則遵守、ツールによる状態変更を十分に扱えていないことを問題視しました。そこで提案されたのがτ-benchです。τ-benchはツール(API)、エージェント、ユーザー(LLMによるシミュレーション)の三者が参加する会話をシミュレートし、回答の内容に加えて最終的なデータベース状態の一致によって客観的に正解を判定します。
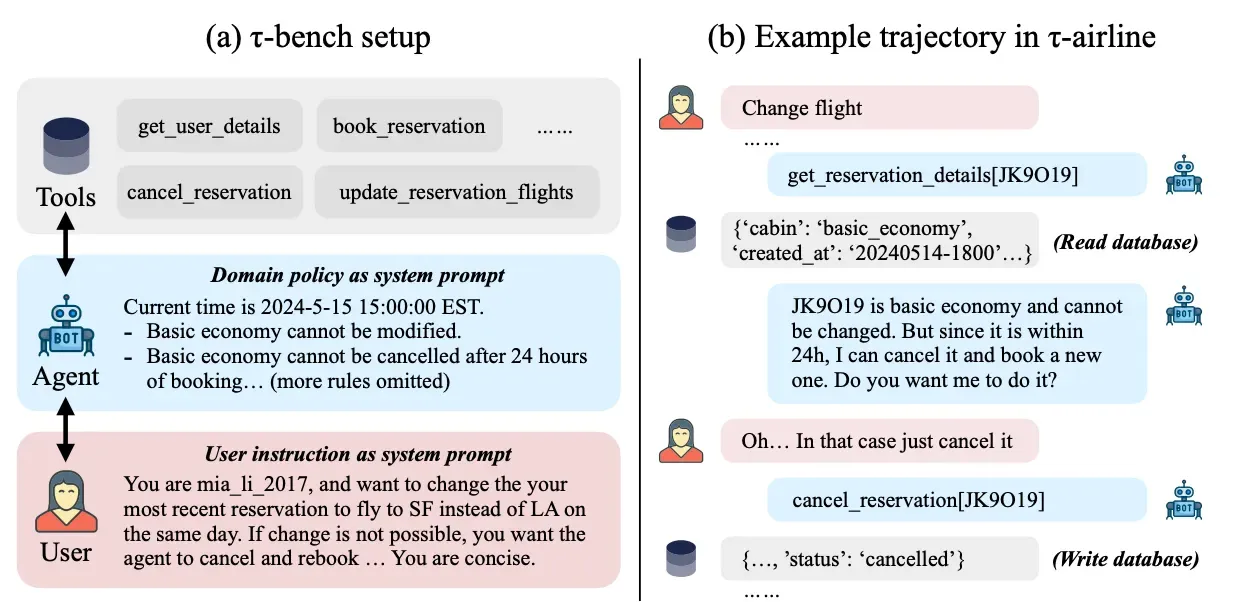
主な特徴は次のとおりです:
- リアルな対話とツール利用:ドメイン固有のAPI(航空と小売)とデータベース(ローカルのJSONファイル)を備え、LLMベースのユーザーがシナリオに沿って情報を問い合わせることで、複数ターンかつ多様なユーザー発言を実現します。
- データベース状態に基づく評価:エージェントの出力の評価はLLM-as-a-judgeやツール利用の確認が一般的ですが、実応用においては「実際に状態を変更したかどうか」が重要です。そこでτ-benchでは、会話のシミュレーション後にデータベースが期待された状態になったかどうかを確認します。
- 信頼性指標 pass^k:pass@k(k回中少なくとも1回成功)の代わりにpass^k(k回すべて成功)を導入し、エージェントの再現性を測ります。3
τ-benchを当時の最先端モデルであったGPT-4oで評価したところ平均成功率は48%で、エージェントとして利用するうえでの課題が浮き彫りになりました。一方で、失敗例を精査するとユーザーシミュレータ側のエラーのためにタスクが実行不可能になっているケースも確認されました。そこでSierra AIのチームは、ユーザー側にもツール利用を強制することでシミュレーションの精度を高めたτ²-bench4を提案しました。以降、AIエージェントのツール利用能力を測るベンチマークとして、さまざまな組織で参照されるようになっています。
ただし、τ-benchはオープンソースであり、異なる組織が発表するベンチマークスコアにはしばしば微妙に異なる設定が追加されていることに注意してください。この記事が警鐘を鳴らしているように、公開スコアを鵜呑みにするのは危険です。
Measuring AI Ability to Complete Long Tasks
- Authors: Thomas Kwa, Ben West, Joel Becker, Amy Deng, Katharyn Garcia, Max Hasin, Sami Jawhar, Megan Kinniment, Nate Rush, Sydney Von Arx, Ryan Bloom, Thomas Broadley, Haoxing Du, Brian Goodrich, Nikola Jurkovic, Luke Harold Miles, Seraphina Nix, Tao Lin, Neev Parikh, David Rein, Lucas Jun Koba Sato, Hjalmar Wijk, Daniel M. Ziegler, Elizabeth Barnes, Lawrence Chan
- Paper: https://arxiv.org/abs/2503.14499
- Blog post: https://metr.org/blog/2025-03-19-measuring-ai-ability-to-complete-long-tasks/
- Venue: NeurIPS 2025
Measuring AI Ability to Complete Long Tasks [Kwa+, 2025]
— Shion Honda (@shion_honda) April 26, 2025
AIシステムの能力を定量化するため、AIが成功率50%で完了できるタスクを、専門知識を持つ人間が完了するのにかかる時間を計測。「50%タスク完了時間」はソフトウェア分野で7か月ごとに倍増している。https://t.co/ItxoPCBTaO#NowReading pic.twitter.com/J3oK7AfvMN
非営利の研究組織「Model Evaluation & Threat Research(METR)」による本論文は、タスクの成功率ではなく「完了にかかる時間」に着目した指標を提案しました。具体的には、ソフトウェア関連のさまざまなタスク(Wikipediaを使った調査から複雑なコーディングまで)について、人間のエキスパートが完了するまでに要する時間(人間時間)を計測し、AIモデルが同じタスクを50%の成功率で完了できるかどうかを比べます。これにより、モデルが自律的に完遂できるタスクの「長さ」を定量化します。論文ではこの指標を50%タスク完了時間の地平(50% task completion time horizon)と呼びます。
このベンチマークを分析すると、以下のようなことがわかりました。
- 2025年3月時点での最先端モデル(Claude 3.7 Sonnet)の50%タスク完了時間は59分でした。ロジスティック曲線を見ると、人間が4分未満で終えるタスクならほぼ100%成功しますが、4時間以上かかるタスクでは成功率が10%以下に落ち込みます。これは、モデルが連続した行動の記憶やエラー回復にまだ弱いことを示しています。
- 2019年以降、50%タスク完了時間は約7か月ごとに倍増しており、予測が継続すれば2028年から2031年の間に1か月かかるタスクを自律的にこなせるようになります。ただし外挿には注意が必要で、アルゴリズムのブレークスルーや環境変化が起こるとトレンドが崩れる可能性があります。
- 伸びを支えているのは単なる推論力だけではなく、エラーからの回復やツール利用能力であると報告されています。これは強化学習やエージェントアプローチによる改善が重要であることを示唆しています。
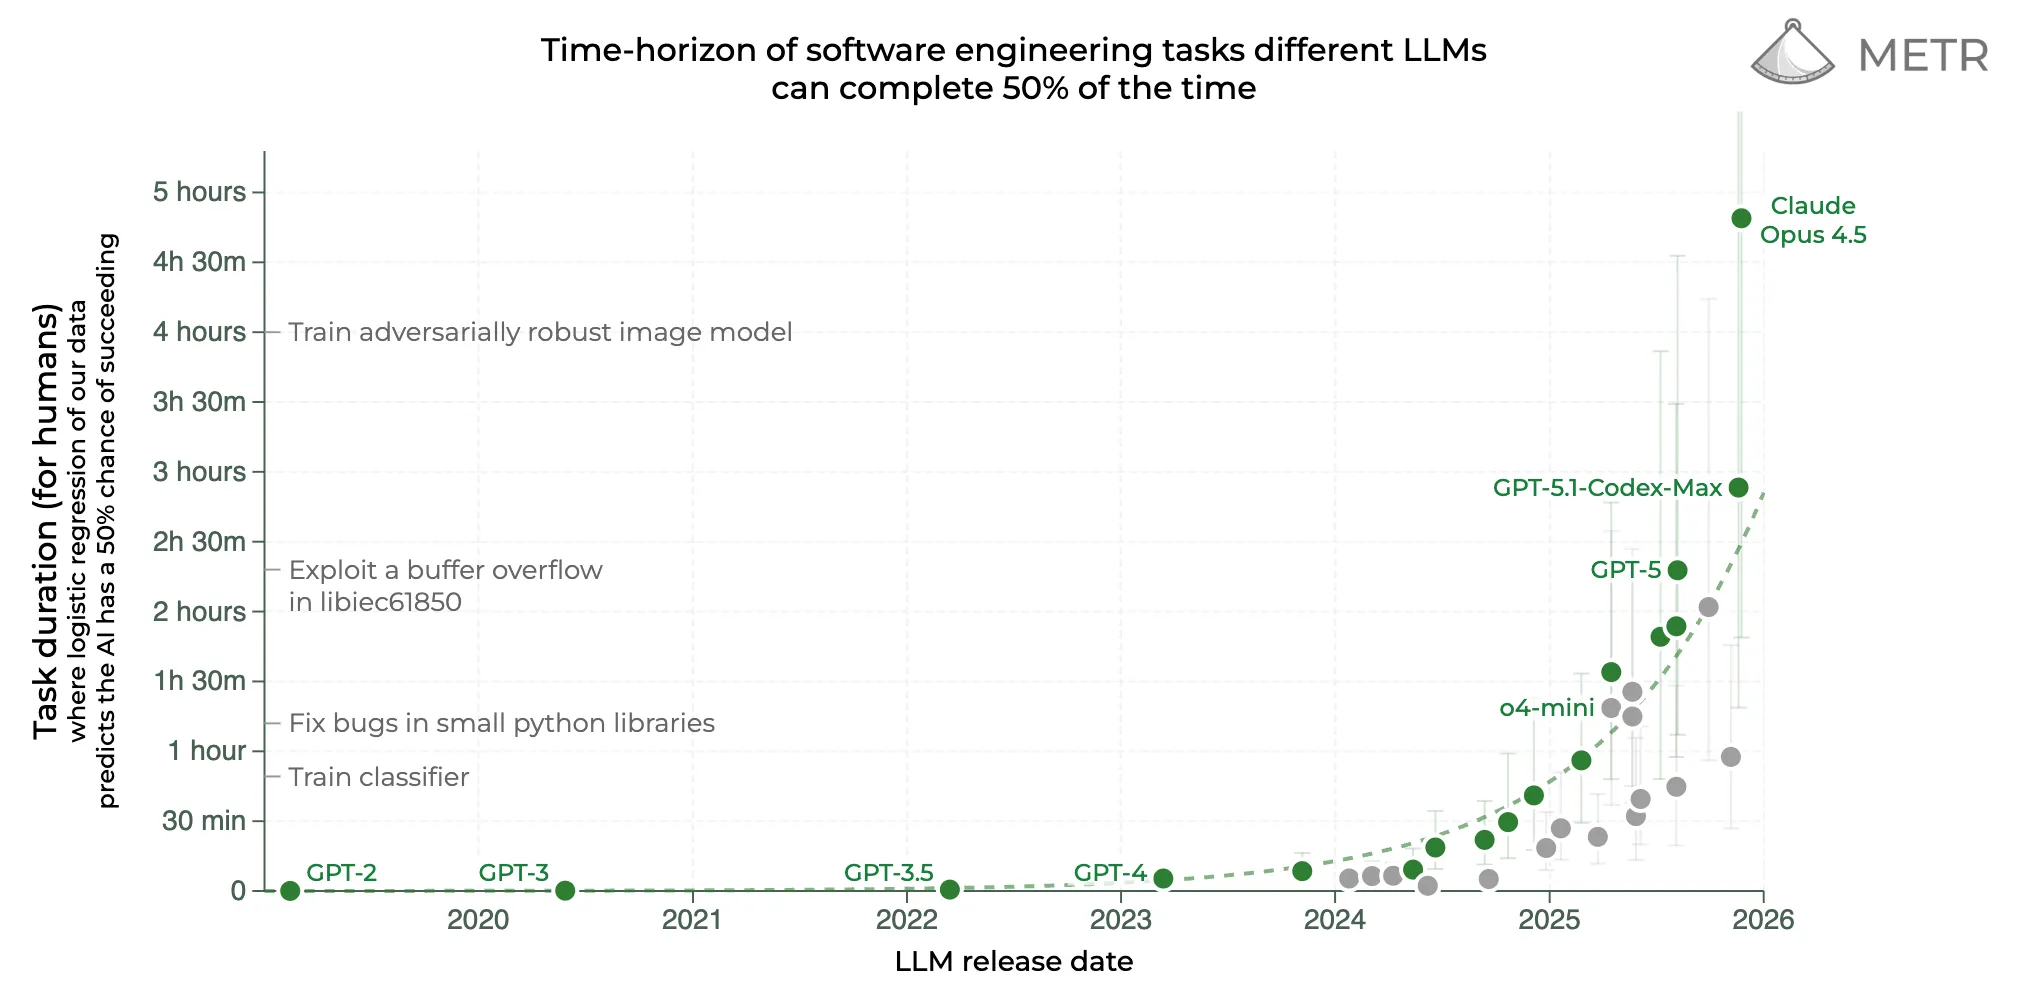
本論文が示す「AI版Mooreの法則」は直近6年の範囲で成立していますが、2025年末時点では限界も見え始めています。5
- 現時点での最新モデルであるGPT-5.1-Codex-Maxは2時間53分、Claude Opus 4.5 は4時間49分という50%タスク完了時間を達成したが、人間が1-4時間かける課題は現在14問しかなく、推定値にノイズが乗りやすい
- タスクのテーマが公開されているため、ある程度対策することが可能である(benchmaxxing)。
- タスクの大半がサイバーセキュリティや機械学習の競技タスクであるため、指標が普遍的な自律能力を示すとは限らない
Why Language Models Hallucinate
- Authors: Adam Tauman Kalai, Ofir Nachum, Santosh S. Vempala, Edwin Zhang
- Paper: https://arxiv.org/abs/2509.04664
- Blog post: https://openai.com/index/why-language-models-hallucinate/
Why LMs Hallucinate [Kalai+, 2025]
— Shion Honda (@shion_honda) September 9, 2025
事前学習のみのLLMは単なる密度推定なので、誕生日クイズのようなパターンのない問題では幻覚が避けられない。事後学習では憶測よりも無知の認識に報酬を与えることで幻覚を防げるが、現在のベンチマークはそうなっていない。https://t.co/9vH0mIx12f#NowReading pic.twitter.com/AkRBcosNW1
OpenAIとGeorgia Techによる本論文は、「LLMがなぜ事実と異なる内容を自信満々に生成するのか」というLLM登場以来の疑問に、統計的な答えを与えます。直感的に説明すると、その理由は現在の評価指標が不正解よりも当てずっぽうを良しとするため、モデルが分からないときに「知らない」と言うよりも推測を選びがちである、というものです。
例えば、モデルの事前学習中に誰かの誕生日を尋ねるとします。正解の確率は1/365ですが、「分からない」と答えると確実に不正解になります。そのため、評価指標が正答率だけだと、モデルは当てずっぽうでも推測するほうが有利になります。言語モデルは文章の流暢さや文法など、パターンに基づく生成は得意ですが、低頻度の固有名詞や日付は十分に学習できません。外部の知識ベースを参照しない限り、幻覚(hallucination)は構造的に生じ得ます。
著者らは、モデルが自らの無知を自覚し、不確実なときに答えない能力(abstain)を獲得するには、正答率だけでなく正直さも評価する必要があると述べています。
OpenAIは、2025年8月に公開したGPT-5で幻覚の大幅な削減を報告し、その後もGPT-5.1、5.2と着実に削減し続けています。本論文は幻覚を減らす具体手法には踏み込まず、GPT-5との因果関係も不明ですが、評価指標の設計がモデルのふるまいを左右するという視点は、今後の品質評価や安全性を考えるうえで重要だと感じました。
おわりに
以上のように、2025年を特徴づけたのは、RLVRの成功とLLMのエージェント化、そしてその能力を評価するための新たなベンチマークの登場だったように感じます。2026年にどのような発展が見られるのか、引き続き注目していきたいと思います。読者の皆様も、よいお年をお迎えください。
Footnotes
-
Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Xiao Bi, Haowei Zhang, Mingchuan Zhang, Y.K. Li, Y. Wu, Daya Guo. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024. ↩
-
Nathan Lambert, Jacob Morrison, Valentina Pyatkin, Shengyi Huang, Hamish Ivison, Faeze Brahman, Lester James V. Miranda, Alisa Liu, Nouha Dziri, Shane Lyu, Yuling Gu, Saumya Malik, Victoria Graf, Jena D. Hwang, Jiangjiang Yang, Ronan Le Bras, Oyvind Tafjord, Chris Wilhelm, Luca Soldaini, Noah A. Smith, Yizhong Wang, Pradeep Dasigi, Hannaneh Hajishirzi. Tulu 3: Pushing Frontiers in Open Language Model Post-Training. COLM. 2025. ↩
-
出力を容易に検証できるタスクではpass@kが、間違いのコストが高いタスクではpass^kが適切です。詳しくは以前のブログ記事をご参照ください。 ↩
-
Victor Barres, Honghua Dong, Soham Ray, Xujie Si, Karthik Narasimhan. τ2-Bench: Evaluating Conversational Agents in a Dual-Control Environment. 2025. ↩
-
Shashwat Goel. How to game the METR plot. 2025. ↩